
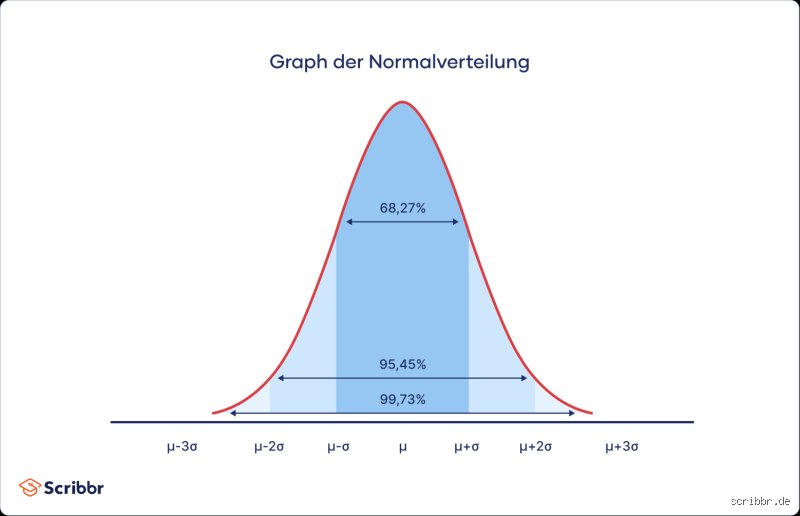
Warum ist Normalverteilung überhaupt so wichtig?
Die Normalverteilung, oft auch Gauß-Verteilung genannt, ist in der Statistik sehr wichtig. Viele statistische Tests, wie der t-Test oder die ANOVA, setzen sie voraus. Das Problem ist aber, dass reale Daten selten perfekt normalverteilt sind. Oft gibt es Abweichungen, die man berücksichtigen muss. Ich habe das selbst schon oft erlebt, dass Daten "fast" normalverteilt waren, aber eben nicht ganz. Und dann stellt sich die Frage: Was nun?
Was bedeutet "keine Normalverteilung" genau?
Einfach gesagt, bedeutet es, dass die Werte in deinem Datensatz nicht der typischen Glockenkurve entsprechen. Vielleicht sind sie schief, haben mehrere Gipfel (multimodal) oder sind einfach unregelmäßig verteilt. Es gibt verschiedene Tests, wie den Shapiro-Wilk-Test oder den Kolmogorov-Smirnov-Test, die dir helfen können, die Normalverteilung zu überprüfen. Aber Achtung: Diese Tests sind empfindlich gegenüber großen Stichproben. Bei sehr großen Datensätzen können sie auch kleine Abweichungen als signifikant einstufen. In solchen Fällen ist es oft sinnvoller, die Daten visuell zu beurteilen, zum Beispiel mit einem Histogramm oder einem Q-Q-Plot.
Die erste Option: Datentransformationen
Eine gängige Methode ist die Transformation der Daten. Das bedeutet, dass du eine mathematische Funktion auf deine Daten anwendest, um sie "normaler" zu machen. Häufig verwendete Transformationen sind der Logarithmus (Log), die Quadratwurzel oder die Box-Cox-Transformation. Zum Beispiel, wenn deine Daten rechtsschief sind (also einen langen "Schwanz" nach rechts haben), kann der Logarithmus oft helfen, die Verteilung symmetrischer zu machen. Aber Achtung: Transformationen verändern auch die Interpretation deiner Ergebnisse. Du musst dir bewusst sein, was die Transformation bedeutet und wie sie deine Schlussfolgerungen beeinflusst. Ich persönlich finde, dass man Transformationen immer mit Bedacht einsetzen sollte. Es ist wichtig zu verstehen, was man tut und warum.
Nicht-parametrische Tests: Die Alternative
Wenn Transformationen nicht funktionieren oder nicht gewünscht sind, gibt es eine ganze Reihe von nicht-parametrischen Tests. Diese Tests machen keine Annahmen über die Verteilung deiner Daten. Sie basieren stattdessen auf Rängen oder Vorzeichen. Beispiele sind der Mann-Whitney-U-Test (als Alternative zum t-Test), der Wilcoxon-Test (für verbundene Stichproben) oder der Kruskal-Wallis-Test (als Alternative zur ANOVA). Der Vorteil dieser Tests ist ihre Robustheit gegenüber Abweichungen von der Normalverteilung. Der Nachteil ist, dass sie oft weniger "Power" haben als parametrische Tests, d.h. sie sind weniger empfindlich gegenüber kleinen Effekten. Das bedeutet, dass du möglicherweise einen Effekt übersiehst, der mit einem parametrischen Test gefunden worden wäre. Ich habe die Erfahrung gemacht, dass die Wahl zwischen parametrischen und nicht-parametrischen Tests oft eine Abwägung zwischen Robustheit und Power ist.
Wann kann ich die Normalverteilungsannahme ignorieren?
Es gibt Situationen, in denen du die Normalverteilungsannahme ignorieren kannst. Zum Beispiel, wenn du eine sehr große Stichprobe hast. Der zentrale Grenzwertsatz besagt, dass die Verteilung des Stichprobenmittelwerts sich einer Normalverteilung annähert, je größer die Stichprobe ist, unabhängig von der Verteilung der Grundgesamtheit. Das bedeutet, dass du auch bei nicht-normalverteilten Daten parametrische Tests verwenden kannst, wenn deine Stichprobe groß genug ist. Aber Achtung: "Groß genug" ist relativ. Es gibt keine feste Regel, ab welcher Stichprobengröße die Normalverteilungsannahme vernachlässigt werden kann. Eine Faustregel ist, dass eine Stichprobengröße von n > 30 oft ausreichend ist, aber das hängt stark von der Art der Daten und dem Test ab, den du verwendest. Ich persönlich bin da immer etwas vorsichtig und schaue mir die Daten trotzdem genau an.
Was ist mit Ausreißern?
Ausreißer können die Normalverteilung stark beeinflussen. Sie können die Verteilung schief machen oder zu einer Multimodalität führen. Es ist wichtig, Ausreißer zu identifizieren und zu untersuchen. Manchmal sind Ausreißer Fehler, die korrigiert oder entfernt werden müssen. Manchmal sind sie aber auch legitime Werte, die wichtige Informationen enthalten. Wie du mit Ausreißern umgehst, hängt stark von der Art der Daten und der Fragestellung ab. Es gibt verschiedene Methoden, um Ausreißer zu behandeln, wie zum Beispiel das Trimmen (Entfernen der extremsten Werte) oder das Winsorisieren (Ersetzen der extremsten Werte durch weniger extreme Werte). Aber auch hier gilt: Sei vorsichtig und überlege dir gut, was du tust. Ich habe schon oft gesehen, dass das Entfernen von Ausreißern zu falschen Schlussfolgerungen geführt hat.
Fazit: Es gibt immer einen Weg
Wie du siehst, gibt es viele Möglichkeiten, mit nicht-normalverteilten Daten umzugehen. Wichtig ist, dass du dir bewusst bist, welche Annahmen deine statistischen Tests machen und wie du mit Abweichungen von diesen Annahmen umgehen kannst. Es gibt keine "One-size-fits-all"-Lösung. Die beste Methode hängt von deinen Daten, deiner Fragestellung und deinen persönlichen Präferenzen ab. Und wenn du dir unsicher bist, frag einen Experten! Manchmal hilft ein Blick von außen, um die richtige Entscheidung zu treffen. Und denk dran: Statistik ist nicht immer einfach, aber sie ist immer spannend!