
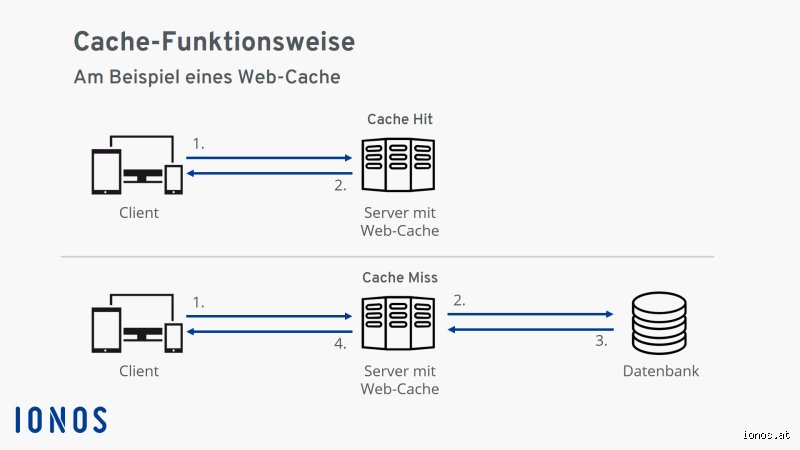
Die meisten Nutzer wissen nur eines: Irgendwann wird der Cache geleert, weil "das hilft". Doch diese Annahme ist so oberflächlich wie ein Kratzer auf einer Glasoberfläche. Denn der Cache ist kein monolithisches Konzept, sondern ein komplexes Geflecht aus Hardware- und Softwarekomponenten, das je nach Anwendung völlig unterschiedliche Aufgaben übernimmt. Browser speichern dort Bilder und Skripte, Prozessoren greifen auf vorab geladene Befehle zurück, und Datenbanken halten häufig abgefragte Ergebnisse bereit. Die eigentliche Frage ist nicht, ob der Cache wichtig ist, sondern wie man ihn gezielt einsetzt – oder im schlimmsten Fall gezielt umgeht.
Was ist ein Cache überhaupt? Mehr als nur ein schneller Zwischenspeicher
Stellen Sie sich vor, Sie arbeiten in einer Bibliothek. Jedes Mal, wenn ein Besucher ein Buch anfordert, müssen Sie durch endlose Regale laufen, es suchen und zurückbringen. Absurd, oder? Genau hier kommt der Cache ins Spiel – er ist wie ein kleiner Tisch direkt neben Ihrem Arbeitsplatz, auf dem die meistgefragten Bücher liegen. Kein lästiges Suchen, kein Warten. Nur sofortiger Zugriff.
Doch diese Analogie greift zu kurz. Denn während der Bibliothekstisch statisch bleibt, passt sich ein Cache dynamisch an. Er lernt, welche Daten häufig benötigt werden, und verwirft alte Einträge, wenn der Platz knapp wird. Das Problem: Diese Intelligenz hat Grenzen. Ein Cache kann nicht hellsehen. Er speichert, was in der Vergangenheit wichtig war – und liegt damit manchmal völlig daneben. Wenn Sie plötzlich ein selten genutztes Programm starten, das jahrelang unberührt blieb, wird der Cache zum Hindernis. Statt zu helfen, bremst er das System aus, weil er erst Platz schaffen muss.
Die drei Cache-Ebenen: Von der CPU bis zur Cloud
Die wenigsten wissen, dass es nicht "den einen" Cache gibt, sondern mehrere Schichten, die wie russische Puppen ineinander verschachtelt sind. Auf der untersten Ebene sitzt der CPU-Cache – winzige Speicherblöcke direkt auf dem Prozessor, die in Nanosekunden arbeiten. L1, L2, L3: Jede Stufe ist größer, aber langsamer als die vorherige. Ein moderner Intel-Core-Prozessor hat beispielsweise 32 KB L1-Cache pro Kern, aber nur 1,25 MB L2. Warum diese Hierarchie? Weil die Physik es so will. Je näher der Speicher am Rechenkern liegt, desto teurer und kleiner wird er. Und doch entscheidet diese Mikroarchitektur darüber, ob ein Spiel flüssig läuft oder ein Server unter Last zusammenbricht.
Dann kommt der RAM-Cache. Betriebssysteme wie Windows oder Linux nutzen den Arbeitsspeicher, um häufig genutzte Dateien oder Programmteile vorzuhalten. Das ist der Grund, warum Ihr Rechner nach dem ersten Start eines Programms schneller wird – das System hat die wichtigsten Daten bereits im RAM geparkt. Doch hier lauert ein klassischer Denkfehler: Viele glauben, mehr RAM bedeute automatisch mehr Cache. Falsch. Der Cache im RAM ist nur ein Teil des Puzzles. Wenn die CPU ständig auf den langsamen Hauptspeicher warten muss, weil der L3-Cache zu klein ist, nützt auch ein Terabyte RAM nichts.
Und schließlich der Software-Cache – der Bereich, den die meisten Nutzer kennen. Browser wie Chrome oder Firefox speichern hier Bilder, CSS-Dateien und JavaScript-Code, um Webseiten schneller zu laden. Datenbanken wie MySQL oder Redis halten Abfrageergebnisse vor, um Serverlast zu reduzieren. Selbst Ihr Smartphone nutzt Caching, um Apps schneller zu starten. Doch während Hardware-Caches fest verdrahtet sind, lassen sich Software-Caches konfigurieren – und genau hier wird es interessant.
Warum Caching manchmal nach hinten losgeht
Es gibt ein berühmtes Zitat aus der Informatik: "There are two hard things in computer science: cache invalidation and naming things." Der erste Teil trifft den Nagel auf den Kopf. Denn der Cache lebt von der Annahme, dass alte Daten noch gültig sind. Doch was passiert, wenn sich die Realität ändert? Wenn eine Webseite aktualisiert wird, aber Ihr Browser noch die veraltete Version anzeigt? Wenn eine Datenbank ein veraltetes Ergebnis zurückgibt, weil der Cache nicht aktualisiert wurde?
Nehmen wir ein konkretes Beispiel: Sie buchen einen Flug, und die Airline zeigt Ihnen einen Preis an. Doch während Sie überlegen, ändert sich die Verfügbarkeit. Wenn der Cache nicht korrekt invalidiert wird, sehen Sie plötzlich einen falschen Preis – und die Airline verliert Geld. Oder schlimmer: Sie kaufen ein Ticket, das es gar nicht mehr gibt. Solche Fehler kosten Unternehmen jährlich Millionen. Und sie zeigen, dass Caching kein Selbstläufer ist. Es erfordert Planung, Überwachung und manchmal sogar manuelle Eingriffe.
Wie der Cache die Performance Ihres Systems beeinflusst – und wann er sie ruiniert
Jeder hat schon die magische Zahl gehört: "Ein Cache kann die Geschwindigkeit um das 10-, 20- oder sogar 100-fache steigern." Doch diese Zahlen sind mit Vorsicht zu genießen. Denn sie gelten nur unter idealen Bedingungen – und die gibt es in der Praxis selten. Die Wahrheit ist: Der Cache ist ein zweischneidiges Schwert. Er kann Wunder wirken, aber auch verheerende Nebenwirkungen haben.
Betrachten wir einen typischen Desktop-PC. Wenn Sie ein Programm starten, lädt das Betriebssystem die wichtigsten Dateien in den RAM-Cache. Beim zweiten Start geht es schneller, weil die Daten bereits vorliegen. Doch was passiert, wenn Sie mehrere speicherhungrige Anwendungen gleichzeitig öffnen? Der Cache wird fragmentiert, alte Einträge werden verdrängt, und plötzlich muss das System wieder auf die langsame Festplatte zugreifen. Das Ergebnis: Ihr Rechner wird langsamer, obwohl Sie nichts falsch gemacht haben.
Der Cache-Miss: Wenn die Theorie versagt
In der Theorie klingt Caching einfach: Daten, die oft benötigt werden, werden zwischengespeichert. Doch in der Praxis gibt es ein zentrales Problem – den Cache-Miss. Das ist der Moment, in dem das System feststellt, dass die benötigten Daten nicht im Cache liegen. Und dann beginnt das Warten: Die CPU muss auf den langsameren Hauptspeicher zugreifen, der Browser lädt die Webseite neu, die Datenbank führt die Abfrage noch einmal aus.
Wie häufig kommen Cache-Misses vor? Das hängt von der Anwendung ab. Bei gut optimierten Systemen liegen die Trefferquoten bei 90% oder mehr. Doch bei schlecht designten Algorithmen kann die Quote auf 50% oder weniger fallen. Und dann wird der Cache zum Bremsklotz. Nehmen wir ein Beispiel aus der Spieleentwicklung: Ein schlecht optimiertes Spiel kann durch häufige Cache-Misses ins Stocken geraten, obwohl die Hardware eigentlich leistungsfähig genug wäre. Die Lösung? Die Entwickler müssen die Datenstrukturen so anpassen, dass sie besser in den Cache passen – ein Prozess, der als Cache-Aware Programming bekannt ist.
Doch selbst bei perfekter Optimierung gibt es Grenzen. Moderne CPUs nutzen sogenannte Prefetching-Algorithmen, die versuchen, zukünftige Speicherzugriffe vorherzusagen. Doch wenn das Programm unvorhersehbar auf Daten zugreift – etwa bei komplexen Datenbankabfragen – versagen diese Mechanismen. Und dann hilft auch der beste Cache nichts.
Wenn der Cache zum Speicherfresser wird
Ein weiteres Problem: Der Cache verbraucht Platz. Und dieser Platz ist nicht unendlich. Browser-Caches können schnell mehrere Gigabyte belegen, wenn sie nicht regelmäßig geleert werden. Bei mobilen Geräten mit begrenztem Speicher kann das zum Problem werden. Doch das Löschen des Caches ist keine triviale Entscheidung. Denn wenn Sie ihn zu oft leeren, verlieren Sie den Performance-Vorteil. Wenn Sie ihn zu selten leeren, wird er ineffizient.
Hier kommt die Cache-Policy ins Spiel – die Regeln, nach denen der Cache entscheidet, welche Daten behalten und welche verworfen werden. Die bekannteste Strategie ist LRU (Least Recently Used): Daten, die am längsten nicht genutzt wurden, werden zuerst gelöscht. Doch diese Methode ist nicht immer optimal. Bei bestimmten Anwendungen – etwa bei Streaming-Diensten – ist es sinnvoller, Daten nach ihrer Größe oder ihrem Alter zu priorisieren. Und genau hier wird es komplex: Es gibt keine universelle Lösung. Jede Anwendung erfordert eine eigene Strategie.
Cache in der Praxis: Wo er wirklich zählt – und wo er überbewertet wird
Nicht jeder Cache ist gleich wichtig. Während ein CPU-Cache für die Performance eines Servers entscheidend sein kann, spielt der Browser-Cache für die meisten Nutzer nur eine untergeordnete Rolle. Doch wo genau liegt der Unterschied? Und wann lohnt es sich, Zeit in die Optimierung zu investieren?
Der Browser-Cache: Nützlich, aber nicht lebenswichtig
Die meisten Nutzer kennen den Browser-Cache als den Ort, an dem Bilder und Skripte zwischengespeichert werden. Und tatsächlich: Wenn Sie eine Webseite zum zweiten Mal besuchen, lädt sie schneller, weil viele Elemente bereits lokal vorliegen. Doch wie groß ist der Effekt wirklich?
Eine Studie von Google aus dem Jahr 2020 zeigte, dass der Browser-Cache die Ladezeit einer Webseite um durchschnittlich 20-30% reduziert. Doch dieser Wert gilt nur für wiederholte Besuche. Beim ersten Aufruf einer Seite bringt der Cache keinen Vorteil. Und selbst bei wiederholten Besuchen gibt es Grenzen: Wenn eine Webseite viele dynamische Inhalte hat – etwa personalisierte Werbung oder Echtzeit-Daten – wird der Cache schnell obsolet.
Doch es gibt einen Bereich, in dem der Browser-Cache wirklich zählt: Offline-Funktionalität. Progressive Web Apps (PWAs) nutzen den Cache, um auch ohne Internetverbindung zu funktionieren. Hier wird der Cache zum Rückgrat der Anwendung. Doch selbst hier ist Vorsicht geboten: Wenn der Cache zu groß wird, kann er die Performance beeinträchtigen. Und wenn er zu klein ist, funktioniert die Offline-Funktionalität nicht richtig.
Der Datenbank-Cache: Der unsichtbare Performance-Booster
Während der Browser-Cache für Endnutzer sichtbar ist, arbeitet der Datenbank-Cache im Hintergrund. Und hier kann er einen echten Unterschied machen. Nehmen wir eine typische E-Commerce-Webseite: Jedes Mal, wenn ein Nutzer nach einem Produkt sucht, führt die Datenbank eine Abfrage aus. Ohne Cache müsste diese Abfrage jedes Mal neu berechnet werden – ein Prozess, der bei großen Datenmengen Sekunden dauern kann. Mit Cache liegt das Ergebnis bereits vor, und die Seite lädt in Millisekunden.
Doch auch hier gibt es Fallstricke. Datenbanken wie MySQL oder PostgreSQL nutzen einen Query Cache, der Abfrageergebnisse zwischenspeichert. Doch wenn sich die Daten häufig ändern – etwa bei einem Live-Ticker oder einer Social-Media-Plattform – wird dieser Cache schnell ungültig. Und dann muss die Datenbank die Abfrage erneut ausführen. Das Ergebnis: Der Cache wird zum Flaschenhals.
Ein weiteres Problem: Der Datenbank-Cache verbraucht Arbeitsspeicher. Und wenn der Cache zu groß wird, kann das System anfangen, Daten auf die Festplatte auszulagern – ein Prozess, der die Performance ruiniert. Die Lösung? Eine sorgfältige Konfiguration. Datenbankadministratoren müssen abwägen zwischen Cache-Größe, Trefferquote und Speicherverbrauch. Und das ist keine triviale Aufgabe.
Der CPU-Cache: Wo Millisekunden über Sieg oder Niederlage entscheiden
Während Browser- und Datenbank-Caches für die meisten Nutzer unsichtbar bleiben, ist der CPU-Cache der heimliche Star der Performance-Optimierung. Denn hier geht es um Nanosekunden. Ein Cache-Miss im L1-Cache kann eine Verzögerung von 4-5 Zyklen bedeuten. Klingt wenig? Bei einer CPU mit 3 GHz entspricht das etwa 1,5 Nanosekunden. Doch wenn diese Verzögerung bei jedem Speicherzugriff auftritt, summiert sich das schnell.
Nehmen wir ein Beispiel aus der Spieleentwicklung: Ein schlecht optimierter Rendering-Algorithmus kann durch häufige Cache-Misses die Framerate halbieren. Die Lösung? Die Entwickler müssen die Daten so anordnen, dass sie besser in den Cache passen – etwa durch Data-Oriented Design. Doch das erfordert ein tiefes Verständnis der Hardware. Und genau hier liegt das Problem: Die meisten Programmierer denken nicht in Cache-Lines, sondern in Objekten und Klassen.
Doch es gibt auch gute Nachrichten: Moderne CPUs werden immer intelligenter. Sie nutzen Branch Prediction und Speculative Execution, um Cache-Misses vorherzusehen und zu vermeiden. Doch diese Techniken haben Grenzen. Und sie können sogar neue Probleme schaffen – wie die berühmten Spectre- und Meltdown-Sicherheitslücken, die durch spekulative Ausführung ausgenutzt werden konnten.
Cache-Strategien: Welche Methode passt zu Ihrem Anwendungsfall?
Es gibt keine universelle Cache-Strategie. Was für eine Webseite funktioniert, kann für eine Datenbank katastrophal sein. Und was für einen Desktop-PC optimal ist, kann auf einem Smartphone völlig falsch sein. Doch es gibt einige bewährte Methoden, die je nach Anwendungsfall eingesetzt werden können.
LRU vs. FIFO: Der Klassiker und seine Alternativen
Die einfachste Cache-Strategie ist FIFO (First In, First Out): Die ältesten Einträge werden zuerst gelöscht. Doch diese Methode hat einen entscheidenden Nachteil: Sie berücksichtigt nicht, wie oft die Daten genutzt werden. Wenn eine Webseite einmal geladen und dann nie wieder besucht wird, bleibt sie trotzdem im Cache – bis sie durch ältere Einträge verdrängt wird.
Besser ist LRU (Least Recently Used): Hier werden die Daten gelöscht, die am längsten nicht genutzt wurden. Diese Methode ist effizienter, aber auch komplexer. Denn das System muss Buch führen, wann welche Daten zuletzt genutzt wurden. Und das kostet Rechenleistung.
Doch selbst LRU hat Grenzen. Bei bestimmten Anwendungen – etwa bei Streaming-Diensten – ist es sinnvoller, Daten nach ihrer Größe oder ihrem Alter zu priorisieren. Hier kommt Size-Adjusted LRU ins Spiel: Größere Dateien werden schneller gelöscht, um Platz für kleinere, häufiger genutzte Daten zu schaffen. Und dann gibt es noch LFU (Least Frequently Used), das Daten nach ihrer Nutzungshäufigkeit bewertet. Doch diese Methode ist aufwendig und wird nur in speziellen Fällen eingesetzt.
Write-Through vs. Write-Back: Wie der Cache mit Schreiboperationen umgeht
Bisher haben wir uns auf Leseoperationen konzentriert. Doch was passiert, wenn Daten geändert werden? Hier kommen zwei grundlegende Strategien ins Spiel: Write-Through und Write-Back.
Bei Write-Through werden Änderungen sofort in den Hauptspeicher geschrieben. Das ist sicher, aber langsam. Denn jede Schreiboperation muss auf den langsamen Hauptspeicher warten. Bei Write-Back werden Änderungen zunächst im Cache gespeichert und erst später in den Hauptspeicher geschrieben. Das ist schneller, aber riskanter. Denn wenn das System abstürzt, bevor die Daten geschrieben wurden, gehen sie verloren.
Welche Methode ist besser? Das hängt von der Anwendung ab. Bei kritischen Systemen – etwa bei Banktransaktionen – ist Write-Through die sicherere Wahl. Bei Performance-kritischen Anwendungen – etwa bei Spielen oder Echtzeit-Systemen – ist Write-Back die bessere Option. Doch selbst hier gibt es Kompromisse: Moderne Systeme nutzen oft eine Kombination aus beiden Methoden, um die Vorteile zu vereinen.
Distributed Caching: Wenn ein Cache nicht reicht
Bei großen Systemen – etwa bei Cloud-Diensten oder Social-Media-Plattformen – reicht ein einzelner Cache nicht aus. Hier kommt Distributed Caching ins Spiel: Mehrere Cache-Server arbeiten zusammen, um die Last zu verteilen. Doch diese Methode bringt neue Herausforderungen mit sich.
Nehmen wir ein Beispiel: Sie betreiben eine Webseite mit Millionen von Nutzern. Jeder Nutzer hat ein persönliches Profil, das häufig abgefragt wird. Wenn Sie einen einzelnen Cache-Server nutzen, wird dieser schnell zum Flaschenhals. Die Lösung? Sie verteilen die Daten auf mehrere Server – etwa mit Redis Cluster oder Memcached. Doch dann stellt sich die Frage: Wie stellen Sie sicher, dass die Daten konsistent bleiben? Wenn ein Nutzer sein Profil aktualisiert, muss diese Änderung auf allen Servern sichtbar sein. Und das erfordert komplexe Synchronisationsmechanismen.
Doch selbst hier gibt es Grenzen. Wenn die Daten zu groß werden, wird der Cache ineffizient. Und wenn die Last zu hoch wird, kann das System kollabieren. Die Lösung? Eine sorgfältige Planung. Sie müssen abwägen zwischen Cache-Größe, Trefferquote und Skalierbarkeit. Und das ist keine triviale Aufgabe.
Die häufigsten Cache-Fehler – und wie Sie sie vermeiden
Caching klingt einfach: Daten zwischenspeichern, Performance steigern. Doch in der Praxis lauern zahlreiche Fallstricke. Viele Entwickler und Administratoren machen dieselben Fehler – oft mit verheerenden Folgen. Hier sind die häufigsten Probleme und wie Sie sie vermeiden.
Fehler 1: Der Cache ist zu groß – oder zu klein
Ein zu kleiner Cache führt zu häufigen Cache-Misses und damit zu Performance-Problemen. Doch ein zu großer Cache kann genauso schädlich sein. Denn wenn der Cache zu viel Arbeitsspeicher belegt, muss das System Daten auf die Festplatte auslagern – ein Prozess, der die Performance ruiniert.
Wie finden Sie die richtige Größe? Das hängt von der Anwendung ab. Bei einem Browser-Cache reichen meist 500 MB bis 1 GB. Bei einer Datenbank kann der Cache mehrere Gigabyte umfassen. Und bei einem CPU-Cache gibt es keine Wahl – hier ist die Größe durch die Hardware vorgegeben. Die Lösung: Messen, testen, anpassen. Nutzen Sie Tools wie Redis-Benchmark oder MySQLTuner, um die optimale Cache-Größe zu finden.
Fehler 2: Der Cache wird nicht invalidiert
Einer der häufigsten Fehler: Der Cache wird nicht aktualisiert, wenn sich die Daten ändern. Das Ergebnis? Veraltete Informationen, falsche Preise, inkonsistente Daten. Und das kann teuer werden. Nehmen wir ein Beispiel aus dem E-Commerce: Ein Kunde sieht einen falschen Preis, weil der Cache nicht aktualisiert wurde. Er kauft das Produkt – und das Unternehmen muss den Verlust tragen.
Wie vermeiden Sie dieses Problem? Durch eine klare Cache-Invalidierungsstrategie. Bei Webseiten können Sie HTTP-Header wie Cache-Control oder ETag nutzen, um die Gültigkeit von Daten zu steuern. Bei Datenbanken können Sie Trigger oder manuelle Invalidierung nutzen. Und bei Anwendungen mit häufigen Änderungen – etwa bei Social-Media-Plattformen – kann es sinnvoll sein, den Cache ganz abzuschalten.
Fehler 3: Der Cache wird zu oft geleert
Das andere Extrem: Der Cache wird zu oft geleert. Viele Nutzer löschen ihren Browser-Cache regelmäßig, weil sie glauben, dass das die Performance verbessert. Doch das Gegenteil ist der Fall. Wenn der Cache zu oft geleert wird, muss das System die Daten jedes Mal neu laden – und das kostet Zeit.
Wie oft sollten Sie den Cache leeren? Das hängt von der Anwendung ab. Bei einem Browser-Cache reicht es meist, ihn alle paar Wochen zu löschen. Bei einer Datenbank kann es sinnvoll sein, den Cache täglich zu invalidieren – etwa nachts, wenn die Last gering ist. Und bei einem CPU-Cache gibt es keine Wahl: Hier wird der Cache automatisch verwaltet.
Fehler 4: Der Cache wird nicht überwacht
Viele Administratoren setzen einen Cache ein – und vergessen ihn dann. Doch ein Cache ist kein Selbstläufer. Er muss überwacht werden, um sicherzustellen, dass er effizient arbeitet. Wenn die Trefferquote sinkt oder die Cache-Größe zu stark ansteigt, ist Handlungsbedarf angesagt.
Wie überwachen Sie den Cache? Nutzen Sie Tools wie Redis-Stat, Memcached-Tool oder MySQL Enterprise Monitor. Diese Tools zeigen Ihnen, wie oft der Cache getroffen wird, wie groß er ist und wie effizient er arbeitet. Und sie warnen Sie, wenn Probleme auftreten.
Frequently Asked Questions: Was Sie schon immer über Caching wissen wollten
Warum wird mein Browser-Cache nicht geleert, obwohl ich es versuche?
Das ist ein häufiges Problem – und es hat mehrere Ursachen. Erstens: Nicht alle Browser-Caches sind gleich. Chrome, Firefox und Edge speichern Daten an unterschiedlichen Orten, und manchmal bleiben Reste zurück. Zweitens: Einige Webseiten nutzen Service Worker, die Daten unabhängig vom Browser-Cache speichern. Und drittens: Wenn Sie den Cache über die Browser-Einstellungen leeren, werden manchmal nur bestimmte Daten gelöscht – etwa Bilder, aber nicht Cookies.
Die Lösung? Nutzen Sie die Entwicklertools Ihres Browsers. In Chrome können Sie unter Einstellungen > Datenschutz und Sicherheit > Browserdaten löschen gezielt auswählen, welche Daten gelöscht werden sollen. Und wenn das nicht hilft, können Sie den Cache manuell löschen – etwa indem Sie den Ordner %LocalAppData%\Google\Chrome\User Data\Default\Cache leeren.
Kann ein zu großer Cache mein System verlangsamen?
Ja, absolut. Ein Cache ist kein magischer Performance-Booster – er ist ein Werkzeug, das richtig eingesetzt werden muss. Wenn der Cache zu groß wird, kann er den Arbeitsspeicher überlasten und dazu führen, dass das System Daten auf die Festplatte auslagert. Und das ist ein Performance-Killer.
Nehmen wir ein Beispiel: Sie haben einen Rechner mit 8 GB RAM. Wenn Ihr Browser-Cache 4 GB belegt und Ihre Datenbank noch einmal 3 GB, bleibt nur noch 1 GB für das Betriebssystem und andere Programme. Und wenn dann ein speicherhungriges Programm startet, muss das System Daten auf die Festplatte auslagern – ein Prozess, der die Performance ruiniert.
Die Lösung? Begrenzen Sie die Cache-Größe. Bei einem Browser-Cache reichen meist 500 MB bis 1 GB. Bei einer Datenbank können Sie die Cache-Größe in der Konfiguration begrenzen – etwa mit innodb_buffer_pool_size in MySQL. Und bei einem CPU-Cache gibt es keine Wahl – hier ist die Größe durch die Hardware vorgegeben.
Warum lädt meine Webseite beim ersten Mal langsam, aber beim zweiten Mal schnell?
Das ist der Cache in Aktion. Beim ersten Aufruf einer Webseite müssen alle Daten – Bilder, CSS-Dateien, JavaScript-Code – vom Server geladen werden. Das dauert. Beim zweiten Aufruf liegen viele dieser Daten bereits im Browser-Cache und müssen nicht mehr heruntergeladen werden. Das Ergebnis: Die Seite lädt schneller.
Doch dieser Effekt hat Grenzen. Wenn die Webseite viele dynamische Inhalte hat – etwa personalisierte Werbung oder Echtzeit-Daten – wird der Cache schnell obsolet. Und wenn der Cache zu klein ist, werden alte Einträge verdrängt, bevor sie wieder genutzt werden können. Die Lösung? Nutzen Sie HTTP-Header wie Cache-Control und ETag, um die Gültigkeit von Daten zu steuern. Und stellen Sie sicher, dass Ihr Server die richtigen Header sendet.
Kann ich den CPU-Cache manuell steuern?
Nein – zumindest nicht direkt. Der CPU-Cache wird automatisch vom Prozessor verwaltet. Sie können ihn nicht manuell leeren oder konfigurieren. Doch Sie können die Performance beeinflussen, indem Sie Ihre Programme cache-freundlich schreiben.
Wie? Durch Cache-Aware Programming. Das bedeutet, dass Sie Ihre Daten so anordnen, dass sie besser in den Cache passen. Nehmen wir ein Beispiel: Wenn Sie ein Array durchlaufen, sollten Sie die Daten in der Reihenfolge speichern, in der sie genutzt werden. Denn wenn Sie wild hin und her springen, führt das zu Cache-Misses – und das bremst das System aus.
Doch selbst hier gibt es Grenzen. Moderne CPUs nutzen komplexe Algorithmen, um Cache-Misses vorherzusehen und zu vermeiden. Und diese Algorithmen sind nicht perfekt. Die Lösung? Testen, messen, optimieren. Nutzen Sie Tools wie VTune oder Perf, um die Cache-Performance zu analysieren. Und passen Sie Ihren Code entsprechend an.
Verdict: Der Cache ist kein Allheilmittel – aber unverzichtbar
Der Cache ist eines dieser technischen Konzepte, die auf den ersten Blick einfach wirken – und sich bei genauerem Hinsehen als komplexes Geflecht aus Hardware, Software und Algorithmen entpuppen. Er kann die Performance eines Systems um das Hundertfache steigern. Doch er kann auch zum Flaschenhals werden, wenn er falsch eingesetzt wird. Die Wahrheit liegt irgendwo dazwischen.
Für die meisten Nutzer ist der Cache unsichtbar – ein unscheinbarer Helfer, der im Hintergrund arbeitet. Doch für Entwickler, Administratoren und Performance-Enthusiasten ist er ein zentrales Werkzeug. Ein Werkzeug, das richtig eingesetzt werden muss. Denn ein Cache ist kein Selbstläufer. Er erfordert Planung, Überwachung und manchmal sogar manuelle Eingriffe.
Und doch: Trotz aller Komplexität ist der Cache unverzichtbar. Ohne ihn würden moderne Computersysteme zusammenbrechen. Webseiten würden ewig laden, Spiele würden ruckeln, und selbst das Öffnen einer einfachen Textdatei würde zur Geduldsprobe. Der Cache ist das unsichtbare Rückgrat der digitalen Welt – und das wird sich so schnell nicht ändern.
Doch es gibt einen entscheidenden Unterschied zwischen einem guten und einem schlechten Cache: die Kontrolle. Die meisten Nutzer haben keine Ahnung, wie ihr Cache funktioniert – und das ist auch nicht nötig. Doch wenn Sie die Performance Ihres Systems wirklich optimieren wollen, müssen Sie verstehen, wie der Cache arbeitet. Sie müssen wissen, wann er hilft und wann er schadet. Und Sie müssen bereit sein, ihn anzupassen, wenn die Umstände es erfordern.
Denn am Ende geht es nicht darum, ob der Cache wichtig ist. Sondern darum, wie Sie ihn nutzen. Und das ist eine Frage, die jeder für sich selbst beantworten muss.