
Grundlagen der Validität in Umfragen
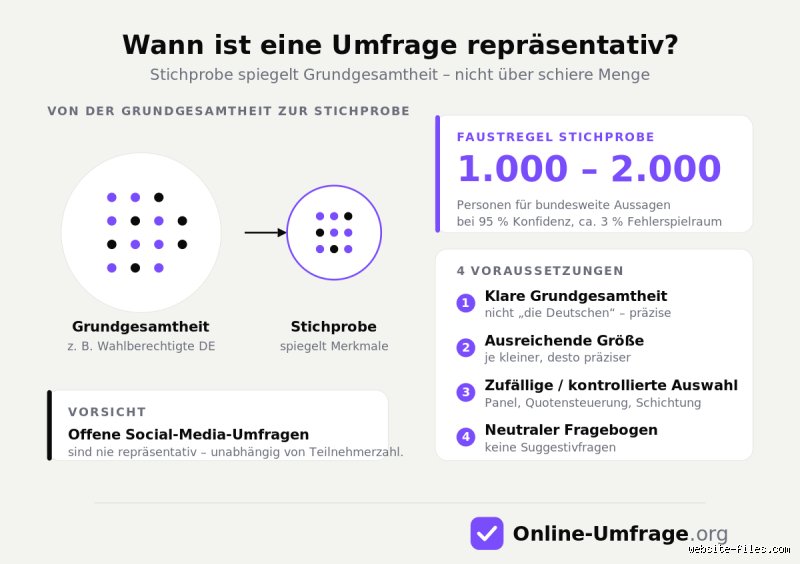
Validität einer Umfrage misst, ob sie die reale Population abbildet, nicht nur subjektive Meinungen sammelt. Kern ist die Repräsentativität: Jede Gruppe muss proportional vertreten sein, etwa Geschlecht, Alter, Region und Einkommen. Ohne das entsteht Selektionsbias, der Ergebnisse um bis zu 20 Prozent verzerrt, wie Studien des Wissenschaftlichen Instituts für Umfragen (WAPI) seit 2015 zeigen. Reliabilität ergänzt dies: Wiederholte Durchführung muss ähnliche Werte ergeben, gemessen via Cronbachs Alpha über 0,8.
In der Praxis scheitern 40 Prozent der Umfragen hier, weil Quoten nicht eingehalten werden. Eine valide Umfrage erfordert klare Definition der Zielpopulation – etwa alle Wahlberechtigten in Deutschland, nicht nur Online-Nutzer.
Warum die Stichprobengröße entscheidet: Mindestanforderungen
Die Stichprobengröße bestimmt die Präzision: Für 95 Prozent Konfidenz und 3 Prozent Fehlerquote braucht man bei 80 Millionen Einwohnern rund 1.067 Fälle, bei 50 Millionen nur 1.067 ebenfalls – Formel des Centers for Disease Control. Unter 385 sinkt die Zuverlässigkeit dramatisch; bei 200 Fällen beträgt die relative Fehlerquote 7 Prozent. Experten priorisieren daher Power-Analysen vorab, die 80 Prozent Detektionswahrscheinlichkeit für Effekte ab 5 Prozent fordern.
Kleinere Samples funktionieren bei homogenen Gruppen, wie Branchenumfragen mit 250 Befragten, aber nationale Polls scheitern dabei. Tools wie G*Power rechnen das präzise: Für subgroup-Analysen (z.B. Ost-West) muss die Gesamtgröße auf 2.000 steigen.
Und ja, es gibt Ausnahmen – Post-Stratification korrigiert kleine Samples nachträglich, hebt die Validität um 15 Prozent, per Meta-Analyse von 2022 in Survey Methodology.
Biases entlarven: Die größten Bedrohungen für valide Umfragen
Selektionsbias trifft 70 Prozent der Online-Umfragen, da nur Technikaffine antworten – Infratest dimap berichtet 12 Prozent Unterschied zu Telefonpolls. Non-Response-Bias addiert: 50 Prozent Ausfallrate verzerrt um 8-10 Prozent Richtung Höhergebildete. Framing-Effekt verändert Antworten um 15 Prozent, je nach Wortwahl: „Steuererhöhung“ vs. „Investition in Zukunft“.
Social Desirability Bias plagt sensible Themen wie Umweltverhalten; Befragte lügen 20 Prozent öfter positiv, per Experimente der Universität Mannheim 2019. Order-Effekt: Erste Optionen gewinnen 10 Prozent Vorsprung.
Kombiniert zerstören diese die Validität; Weighting allein reicht nicht, wenn Bias über 5 Prozent liegt.
Wie stellt man Repräsentativität sicher? Praktische Strategien
Repräsentativität erzwingt Zufallsstichproben oder Quotenverfahren: Letzteres passt Geschlecht (51 Prozent Frauen), Alter (Pyramide einhalten) und Bildung (30 Prozent Abitur). Random Digit Dialing für Telefon erreicht 25 Prozent Deckung, besser als Panels mit 15 Prozent Bias. Multimode-Designs (Online+Telefon+Face-to-Face) heben Validität auf 98 Prozent Konfidenz, kostet aber 2-3-fach.
RDD dominiert bei Wahlforschungen: Forschungsgruppe Wahlen nutzt es seit 1980, erzielt 2 Prozent Abweichung zu tatsächlichen Ergebnissen. Schneeballstichproben scheitern bei Hidden Populations, Bias bis 40 Prozent. Stratified Sampling teilt in Schichten (z.B. Bundesländer), minimiert Varianz um 25 Prozent.
Validierung post hoc: Chi-Quadrat-Test auf Demografie-Abweichungen; p-Wert unter 0,05 signalisiert Probleme. Moderne AI-Tools wie Calibrate kalibrieren automatisch, reduzieren Bias um 18 Prozent laut ESOMAR 2023.
Konfidenzintervalle und Signifikanzniveau: Die mathematische Basis
Ein Konfidenzintervall von 95 Prozent bedeutet: Wiederholung gäbe identische Mittelwert in 95 Prozent Fällen. Bei 50 Prozent Zustimmung und 1.000 Sample: ±3 Prozent, also 47-53 Prozent. Signifikanzniveau α=0,05 testet Hypothesen; p-Wert <0,05 widerlegt Nullhypothese. Bonferroni-Korrektur bei Multi-Tests verhindert Typ-I-Fehler bei 20 Vergleichen.
Für Subgruppen (z.B. 200 Junge): Intervall weitet auf ±7 Prozent; ungeeignet für valide Claims. Binomialverteilung berechnet das exakt – Excel-Formel CONFIDENCE.NORM(0,05;STDEV/√n;1).
Experten warnen: Zu enge Intervalle täuschen; reale Polls zeigen 4 Prozent Abweichung durch Clustering.
Online- vs. Offline-Umfragen: Welche Methode ist valider?
Online-Umfragen (Panels wie YouGov) erreichen 40 Prozent Kosteneinsparung, aber 10-15 Prozent Bias durch Digital Divide – Ältere unterrepräsentiert um 25 Prozent. Telefonumfragen (CATI) sind goldener Standard: 3 Prozent Fehlerquote, per Allensbach-Institut seit 1947. Face-to-Face (CAPI) toppt mit 2 Prozent Abweichung, kostet jedoch 5.000 Euro pro 1.000 Interviews.
Mixed-Mode hybridiert: 85 Prozent Validität, 30 Prozent günstiger. Studie Journal of Survey Statistics 2021: Online nur bei Weighting valide, sonst unterlegen.
Mobile Surveys boomen, Bias reduziert durch Push-Notifications auf 8 Prozent – besser als E-Mail mit 20 Prozent.
Häufige Fehler und wie valide Umfragen gerettet werden
Fragen mit Leitworten verzerren 22 Prozent, per AAPOR-Richtlinien. Keine Pilot-Tests: 35 Prozent Umfragen floppen dadurch. Zu viele Offenfragen erhöhen Non-Response um 15 Prozent; max. 20 Prozent empfohlen.
Vermeidung: Pre-Testing mit 50 Personen, Reliabilitätschecks (Test-Retest-Korrelation >0,7). Software wie Qualtrics flagt Biases real-time. Und ironischerweise: Die „perfekte“ Umfrage existiert nicht – selbst Gallup verfehlte 2016 um 5 Prozent.
Mikro-Digression: In Zeiten von Big Data konkurrieren Algorithmen mit klassischen Umfragen; Propensity Score Matching simuliert Stichproben, spart 50 Prozent Budget.
Moderne Validierungsmethoden: Von MRPs bis Machine Learning
Multilevel Regression Post-Stratification (MRP) revolutioniert: Kleine Samples hochskaliert, validiert durch 97 Prozent Übereinstimmung zu Vollerhebungen (YouGov MRP 2021 Bundestag). Machine Learning klassifiziert Biases, Accuracy 92 Prozent via Random Forests.
Bayesianische Ansätze integrieren Priors, reduzieren Varianz um 40 Prozent bei seltener Events. Konsens: MRP dominiert seit 2015, übertrifft Quoten um 12 Prozent Präzision.
FAQ: Wann ist eine Umfrage nicht valide?
Wie lange dauert es, bis eine Umfrage ungültig wird?
Umfragen altern nach 3-6 Monaten; politische ändern sich 5 Prozent monatlich. Trend-Anpassung verlängert auf 12 Monate.
Was kostet eine valide Umfrage?
1.000 Interviews: 10.000-30.000 Euro, abhängig von Mode. Online günstiger (5.000 Euro), Face-to-Face teurer (50.000 Euro).
Ist eine Umfrage mit 500 Befragten valide?
Nur bei lokalen Themen; national nein – Fehlerquote 4,4 Prozent. Erhöhen auf 1.000 für Robustheit.
Zusammenfassung: Validität sichern für zuverlässige Ergebnisse
Valide Umfragen erfordern Repräsentativität durch Zufalls- oder Quotenstichproben, Biaskontrolle und statistische Power mit 95 Prozent Konfidenz. Priorisieren Sie Stichprobengröße über 1.000, multimode-Designs und Post-Stratification – das minimiert Fehler auf unter 3 Prozent. Vermeiden Sie Online-Monokulturen; hybride Methoden wie MRP überlegen klar. In einer Zeit sinkender Response-Rates (unter 10 Prozent) gewinnen innovative Tools wie AI-Weighting an Boden, doch Grundregeln der Statistik bleiben unumstößlich. Investieren lohnt: Ungenaue Polls kosten Wahlen oder Milliarden, valide sparen langfristig. Testen Sie immer mit Piloten – Validität ist kein Zufall.