
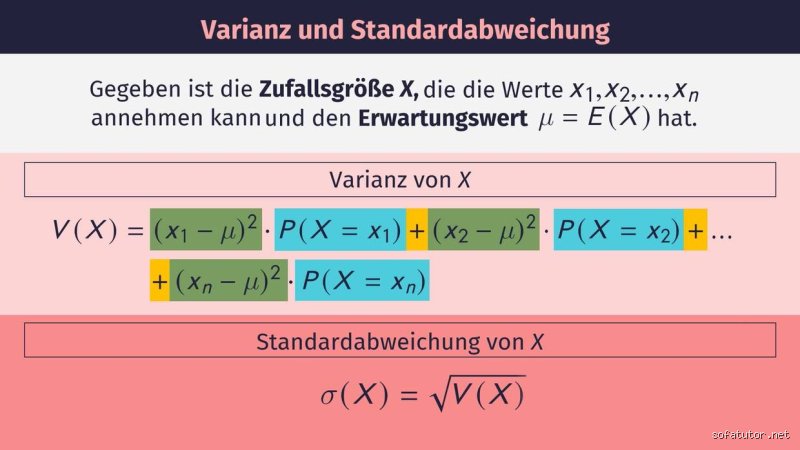
Doch warum sollte Sie das kümmern? Weil diese beiden Kennzahlen entscheiden, ob Ihre Qualitätskontrolle funktioniert, ob Ihr Aktienportfolio stabil bleibt oder ob Ihr Experiment tatsächlich etwas Neues entdeckt hat. Und weil sie in fast jedem Bericht auftauchen – von der Medizin bis zur Klimaforschung. Also: Lassen Sie uns nicht nur rechnen, sondern verstehen, was diese Zahlen wirklich bedeuten.
Varianz: Das unsichtbare Chaos hinter den Daten
Stellen Sie sich vor, Sie messen die Körpergröße von zehn zufällig ausgewählten Erwachsenen. Die Werte liegen zwischen 165 und 185 Zentimetern – auf den ersten Blick eine überschaubare Spanne. Doch die Varianz schaut genauer hin. Sie berechnet, wie weit jeder einzelne Wert vom Durchschnitt abweicht, quadriert diese Abweichungen (damit sich positive und negative Unterschiede nicht aufheben) und bildet dann den Mittelwert dieser Quadrate. Das Ergebnis? Ein einziger Wert, der Ihnen sagt: Wie weit sind die Daten im Schnitt vom Mittelwert entfernt – aber in einer Einheit, die niemand intuitiv versteht.
Nehmen wir ein konkretes Beispiel. Angenommen, Sie haben folgende Körpergrößen in Zentimetern: 170, 172, 175, 178, 180. Der Mittelwert beträgt 175. Die Abweichungen vom Mittelwert sind -5, -3, 0, +3, +5. Quadriert ergeben sie 25, 9, 0, 9, 25. Die Summe dieser Quadrate ist 68, geteilt durch die Anzahl der Werte (5) ergibt eine Varianz von 13,6 cm². Ja, cm² – eine Fläche, obwohl wir über Längen sprechen. Und genau hier fängt das Problem an.
Die Varianz ist mathematisch elegant, aber praktisch oft unhandlich. Sie wird in Quadrat-Einheiten angegeben, was in vielen Fällen wenig Sinn ergibt. Wenn Sie die Streuung von Temperaturen in Grad Celsius messen, erhalten Sie eine Varianz in Grad² – eine Einheit, die niemandem etwas sagt. Deshalb brauchen wir die Standardabweichung. Sie ist nichts anderes als die Wurzel der Varianz und bringt die Streuung zurück in die ursprüngliche Einheit. Im Beispiel oben: √13,6 ≈ 3,7 cm. Plötzlich wird die Zahl greifbar.
Warum quadrieren wir überhaupt?
Eine berechtigte Frage. Warum nicht einfach die absoluten Abweichungen mitteln? Die Antwort liegt in der Mathematik: Quadratische Abweichungen sind differenzierbar, was für viele statistische Methoden entscheidend ist. Lineare Abweichungen (also Beträge) haben an der Stelle null eine "Knickstelle", die Berechnungen erschwert. Die Varianz glättet das – und ermöglicht so fortgeschrittene Analysen wie die Regression oder die Varianzanalyse.
Doch es gibt einen Haken. Weil wir quadrieren, reagiert die Varianz extrem empfindlich auf Ausreißer. Ein einziger extrem hoher oder niedriger Wert kann die Varianz in die Höhe treiben, selbst wenn alle anderen Werte eng beieinanderliegen. Das ist Fluch und Segen zugleich. Einerseits macht es die Varianz zu einem sensiblen Werkzeug, um ungewöhnliche Datenpunkte zu erkennen. Andererseits kann sie ein verzerrtes Bild liefern, wenn die Daten nicht normalverteilt sind.
Wann Varianz allein nicht reicht
Die Varianz ist ein mächtiges Werkzeug – aber sie hat Grenzen. Wenn Ihre Daten schief verteilt sind (etwa bei Einkommensdaten, wo einige Superreiche die Statistik verzerren), sagt die Varianz wenig über die tatsächliche Streuung aus. Hier kommen andere Maße ins Spiel, wie der Interquartilsabstand (IQR) oder die mittlere absolute Abweichung. Die Varianz ist wie ein Hochleistungsmikroskop: Sie zeigt Details, die andere Methoden übersehen – aber sie ist nicht immer das richtige Werkzeug für den Job.
Und dann ist da noch die Frage der Interpretation. Eine Varianz von 100 mag in einem Kontext riesig sein (etwa bei der Messung von Blutdruckwerten), in einem anderen völlig normal (etwa bei der Streuung von Aktienrenditen). Zahlen allein sagen nichts aus – es kommt immer auf den Kontext an.
Standardabweichung: Die Sprache der Streuung
Wenn die Varianz der stille Star der Statistik ist, dann ist die Standardabweichung der charmante Botschafter. Sie übersetzt die kryptische Quadrat-Einheit der Varianz zurück in eine verständliche Zahl. Plötzlich können Sie sagen: "Die Werte weichen im Schnitt um 5 Einheiten vom Mittelwert ab" – und jeder versteht, was gemeint ist. Doch die Standardabweichung kann noch mehr.
Sie ist der Schlüssel zur Normalverteilung. In einer perfekten Glockenkurve liegen etwa 68% aller Werte innerhalb einer Standardabweichung vom Mittelwert, 95% innerhalb von zwei und 99,7% innerhalb von drei. Das ist die berühmte 68-95-99,7-Regel. Doch Vorsicht: Diese Regel gilt nur für normalverteilte Daten. Bei schiefen Verteilungen oder Ausreißern wird sie schnell zur Lüge.
Wie Sie die Standardabweichung richtig lesen
Nehmen wir an, Sie messen die Wartezeit in einer Arztpraxis. Der Mittelwert beträgt 20 Minuten, die Standardabweichung 5 Minuten. Was bedeutet das konkret?
Es bedeutet nicht, dass jeder Patient genau 20 Minuten wartet. Es bedeutet, dass die meisten Wartezeiten zwischen 15 und 25 Minuten liegen (Mittelwert ± eine Standardabweichung). Doch es gibt Ausnahmen: Einige Patienten warten nur 10 Minuten, andere 30. Die Standardabweichung sagt Ihnen, wie stark diese Abweichungen im Schnitt sind – nicht, wie extrem sie werden können.
Hier liegt ein häufiges Missverständnis. Viele glauben, die Standardabweichung gebe die maximale Abweichung an. Doch das stimmt nicht. Sie ist ein Maß für die typische Streuung. In einer Normalverteilung können Werte theoretisch unendlich weit vom Mittelwert entfernt sein – auch wenn die Wahrscheinlichkeit dafür extrem gering ist.
Standardabweichung in der Praxis: Drei Beispiele, die alles verändern
1. Qualitätskontrolle in der Produktion
Stellen Sie sich vor, Sie stellen Schrauben her. Der Soll-Durchmesser beträgt 10 mm, die Standardabweichung 0,1 mm. Das klingt nach wenig – bis Sie merken, dass 99,7% aller Schrauben zwischen 9,7 und 10,3 mm liegen. Plötzlich wird klar: Wenn Ihr Kunde Schrauben mit einer Toleranz von ±0,2 mm verlangt, haben Sie ein Problem. Die Standardabweichung zeigt Ihnen, ob Ihre Produktion stabil läuft – oder ob Sie bald Ausschuss produzieren.
2. Finanzmärkte: Warum Volatilität mehr ist als nur ein Schlagwort
In der Finanzwelt ist die Standardabweichung der Renditen gleichbedeutend mit Volatilität. Ein Fonds mit einer jährlichen Standardabweichung von 15% schwankt stärker als einer mit 5%. Doch was bedeutet das für Sie? Es bedeutet, dass Ihr Portfolio im ersten Fall mit höherer Wahrscheinlichkeit extreme Ausschläge erlebt – nach oben wie nach unten. Die Standardabweichung sagt Ihnen nicht, ob die Rendite positiv oder negativ sein wird. Sie sagt Ihnen nur, wie wild die Fahrt wird. Und das ist entscheidend für Ihr Risikomanagement.
3. Medizin: Warum kleine Unterschiede große Folgen haben
Angenommen, ein neues Medikament senkt den Blutdruck im Schnitt um 10 mmHg. Klingt gut – bis Sie die Standardabweichung sehen: 15 mmHg. Plötzlich wird klar, dass das Medikament bei einigen Patienten den Blutdruck kaum verändert, bei anderen aber um 25 mmHg senkt. Und bei wieder anderen könnte es den Blutdruck sogar erhöhen. Die Standardabweichung zeigt Ihnen, ob ein Medikament zuverlässig wirkt – oder ob es eine Lotterie ist.
Varianz vs. Standardabweichung: Wann Sie welche verwenden sollten
Beide Maße messen dasselbe – die Streuung der Daten. Doch sie haben unterschiedliche Stärken und Schwächen. Die Frage ist nicht, welche besser ist, sondern welche in Ihrem Kontext die richtige Antwort liefert.
Varianz: Der Mathematiker-Favorit
Die Varianz ist das Arbeitstier der Statistik. Sie wird in fast allen fortgeschrittenen Methoden verwendet – von der Varianzanalyse (ANOVA) bis zur linearen Regression. Warum? Weil sie mathematisch einfacher zu handhaben ist. Die Summe der quadrierten Abweichungen hat nützliche Eigenschaften, die lineare Abweichungen nicht bieten. Wenn Sie also statistische Modelle bauen, ist die Varianz Ihr Freund.
Doch Vorsicht: Die Varianz ist anfällig für Ausreißer. Ein einziger extrem hoher Wert kann sie in die Höhe treiben, selbst wenn alle anderen Werte eng beieinanderliegen. Wenn Ihre Daten viele Ausreißer enthalten, sollten Sie über robustere Maße nachdenken – oder die Daten vorher bereinigen.
Standardabweichung: Der Praktiker-Klassiker
Die Standardabweichung ist die bevorzugte Wahl, wenn es um Kommunikation geht. Sie ist intuitiv verständlich, weil sie in der gleichen Einheit wie die Daten selbst angegeben wird. Wenn Sie einem Laien erklären müssen, wie stark Ihre Daten streuen, ist die Standardabweichung die bessere Wahl.
Doch auch sie hat ihre Tücken. Weil sie die Wurzel der Varianz ist, unterschätzt sie die tatsächliche Streuung bei nicht-normalverteilten Daten. Und sie sagt nichts über die Form der Verteilung aus. Eine Standardabweichung von 5 kann bei einer Normalverteilung ganz anders aussehen als bei einer schiefen Verteilung.
Wann Sie beide ignorieren sollten
Es gibt Fälle, in denen weder Varianz noch Standardabweichung die richtige Wahl sind. Wenn Ihre Daten extrem schief verteilt sind (etwa bei Einkommensdaten) oder viele Ausreißer enthalten, sind robustere Maße wie der Interquartilsabstand (IQR) oder die mittlere absolute Abweichung (MAD) oft aussagekräftiger. Diese Maße reagieren weniger empfindlich auf extreme Werte und geben ein realistischeres Bild der Streuung.
Und dann ist da noch die Frage der Stichprobengröße. Bei kleinen Stichproben (n < 30) sind Varianz und Standardabweichung oft unzuverlässig. Hier sollten Sie auf Methoden zurückgreifen, die speziell für kleine Stichproben entwickelt wurden – etwa den t-Test oder nichtparametrische Verfahren.
Die fünf häufigsten Fehler – und wie Sie sie vermeiden
Varianz und Standardabweichung sind mächtige Werkzeuge – aber sie werden oft falsch eingesetzt. Hier sind die fünf häufigsten Fallstricke – und wie Sie sie umgehen.
1. Verwechslung von Stichproben- und Populationsstandardabweichung
Das ist der Klassiker. Wenn Sie die Standardabweichung einer Stichprobe berechnen, teilen Sie durch n-1 (Bessel-Korrektur). Wenn Sie die Standardabweichung der gesamten Population berechnen, teilen Sie durch n. Der Unterschied mag klein erscheinen – doch er kann Ihre Ergebnisse komplett verfälschen.
Warum die Korrektur? Weil die Stichprobenvarianz dazu neigt, die Populationsvarianz zu unterschätzen. Die Bessel-Korrektur gleicht diesen Bias aus. Wenn Sie also eine Stichprobe analysieren, immer durch n-1 teilen. Wenn Sie die gesamte Population vor sich haben, teilen Sie durch n.
2. Annahme einer Normalverteilung, wo keine ist
Die 68-95-99,7-Regel ist verführerisch einfach. Doch sie gilt nur für normalverteilte Daten. Wenn Ihre Daten schief sind oder Ausreißer enthalten, wird die Regel zur Farce. Ein Beispiel: Bei Einkommensdaten liegen oft 90% der Werte innerhalb von zwei Standardabweichungen – nicht 95%. Überprüfen Sie immer, ob Ihre Daten normalverteilt sind (etwa mit einem Q-Q-Plot oder dem Shapiro-Wilk-Test), bevor Sie die Regel anwenden.
3. Ausreißer ignorieren
Varianz und Standardabweichung reagieren extrem empfindlich auf Ausreißer. Ein einziger extrem hoher Wert kann beide Maße in die Höhe treiben – selbst wenn alle anderen Werte eng beieinanderliegen. Bevor Sie also Varianz oder Standardabweichung berechnen, sollten Sie Ihre Daten auf Ausreißer prüfen. Methoden wie der IQR oder der Z-Score helfen dabei. Und wenn Sie Ausreißer finden? Entscheiden Sie, ob sie echt sind oder auf Messfehler zurückgehen. Löschen Sie sie nicht einfach – verstehen Sie sie.
4. Standardabweichung als Maß für Risiko missverstehen
In der Finanzwelt wird die Standardabweichung oft als Risikomaß verwendet. Doch sie misst nur die Volatilität – nicht das Risiko im eigentlichen Sinne. Eine hohe Standardabweichung bedeutet nicht automatisch, dass eine Anlage riskant ist. Sie bedeutet nur, dass die Renditen stark schwanken. Risiko ist mehr als nur Volatilität. Es umfasst auch die Wahrscheinlichkeit eines Totalverlusts, die Liquidität und andere Faktoren. Die Standardabweichung ist ein Werkzeug – kein Orakel.
5. Varianz und Standardabweichung isoliert betrachten
Varianz und Standardabweichung sagen Ihnen, wie stark Ihre Daten streuen – aber nicht, warum. Wenn Sie eine hohe Standardabweichung sehen, sollten Sie immer fragen: Was steckt dahinter? Sind es echte Unterschiede in den Daten? Messfehler? Eine schiefe Verteilung? Ohne Kontext sind Varianz und Standardabweichung nur Zahlen – keine Erkenntnisse.
Wie Sie Varianz und Standardabweichung in Excel und Python berechnen
Die Theorie ist das eine – die Praxis das andere. Hier erfahren Sie, wie Sie Varianz und Standardabweichung mit gängigen Tools berechnen – und welche Fallstricke Sie dabei beachten müssen.
Excel: Schnell, aber mit Tücken
Excel bietet zwei Funktionen für die Varianz:
=VAR.P() berechnet die Populationsvarianz (Division durch n).
=VAR.S() berechnet die Stichprobenvarianz (Division durch n-1).
Für die Standardabweichung gibt es analog:
=STDEV.P() (Populationsstandardabweichung)
=STDEV.S() (Stichprobenstandardabweichung)
Doch Vorsicht: Excel verwendet standardmäßig die Bessel-Korrektur (n-1) für Stichproben. Wenn Sie die Populationsstandardabweichung berechnen wollen, müssen Sie explizit =STDEV.P() verwenden. Und wenn Ihre Daten Lücken enthalten? Excel ignoriert leere Zellen – was zu falschen Ergebnissen führen kann, wenn die Lücken nicht zufällig sind.
Python: Flexibel, aber komplexer
In Python können Sie Varianz und Standardabweichung mit NumPy oder Pandas berechnen. Hier ein Beispiel mit NumPy:
import numpy as np

daten = [170, 172, 175, 178, 180]
varianz = np.var(daten, ddof=1) # Stichprobenvarianz
standardabweichung = np.std(daten, ddof=1) # Stichprobenstandardabweichung
Der Parameter ddof=1 aktiviert die Bessel-Korrektur (Division durch n-1). Ohne diesen Parameter berechnet NumPy die Populationsvarianz. Pandas bietet ähnliche Funktionen:
import pandas as pd

df = pd.DataFrame({'groesse': [170, 172, 175, 178, 180]})
varianz = df['groesse'].var() # Stichprobenvarianz
standardabweichung = df['groesse'].std() # Stichprobenstandardabweichung
Der Vorteil von Python: Sie können die Berechnung leicht in größere Analysen einbetten. Der Nachteil: Sie müssen sich mit den Details auseinandersetzen – etwa der Frage, ob Sie die Stichproben- oder Populationsvarianz berechnen wollen.
R: Der Statistiker-Favorit
In R geht es noch einfacher:
daten <- c(170, 172, 175, 178, 180)
varianz <- var(daten) # Stichprobenvarianz
standardabweichung <- sd(daten) # Stichprobenstandardabweichung
R verwendet standardmäßig die Bessel-Korrektur. Wenn Sie die Populationsvarianz berechnen wollen, müssen Sie selbst Hand anlegen:
populationsvarianz <- var(daten) * (length(daten) - 1) / length(daten)
R ist besonders nützlich, wenn Sie fortgeschrittene statistische Analysen durchführen. Doch auch hier gilt: Verstehen Sie, was die Funktionen tun – sonst interpretieren Sie die Ergebnisse falsch.
Frequently Asked Questions: Was Sie schon immer über Varianz und Standardabweichung wissen wollten
Warum quadrieren wir die Abweichungen – und nehmen nicht einfach die Beträge?
Eine berechtigte Frage. Die Antwort liegt in der Mathematik. Quadratische Abweichungen haben zwei entscheidende Vorteile:
1. Sie sind differenzierbar. Das ist wichtig für fortgeschrittene statistische Methoden wie die Regression oder die Maximum-Likelihood-Schätzung. Lineare Abweichungen (Beträge) haben an der Stelle null eine "Knickstelle", die Berechnungen erschwert.
2. Sie gewichten große Abweichungen stärker. Eine Abweichung von 10 wird durch das Quadrieren zu 100 – eine Abweichung von 2 nur zu 4. Das macht die Varianz empfindlicher für Ausreißer – was in vielen Fällen erwünscht ist.
Doch es gibt auch Nachteile. Weil wir quadrieren, reagiert die Varianz extrem empfindlich auf Ausreißer. Und die Einheit wird zur Quadrat-Einheit – was die Interpretation erschwert. Deshalb ziehen wir am Ende die Wurzel und erhalten die Standardabweichung.
Kann die Standardabweichung größer sein als der Mittelwert?
Ja – und das ist kein Fehler. Die Standardabweichung kann sogar größer sein als der Mittelwert selbst. Ein klassisches Beispiel sind Daten mit vielen Nullen und einigen extrem hohen Werten. Nehmen wir an, Sie messen die täglichen Verkäufe eines Produkts. Die meisten Tage verkaufen Sie nichts (0), aber an einigen Tagen verkaufen Sie 100 Stück. Der Mittelwert könnte bei 5 liegen – die Standardabweichung aber bei 20. Das ist kein Grund zur Sorge. Es bedeutet nur, dass Ihre Daten extrem streuen.
Doch Vorsicht: Wenn die Standardabweichung größer ist als der Mittelwert, sollten Sie sich die Verteilung genauer anschauen. Oft deutet das auf eine schiefe Verteilung oder viele Ausreißer hin. In solchen Fällen sind Varianz und Standardabweichung vielleicht nicht die besten Maße für die Streuung.
Wie interpretiert man die Standardabweichung bei nicht-normalverteilten Daten?
Die Standardabweichung ist ein Kind der Normalverteilung. Bei nicht-normalverteilten Daten verliert sie einen Teil ihrer Aussagekraft. Die 68-95-99,7-Regel gilt nicht mehr – und die Standardabweichung kann die tatsächliche Streuung unter- oder überschätzen.
Was tun? Zunächst: Visualisieren Sie Ihre Daten. Ein Histogramm oder ein Boxplot zeigt Ihnen, ob die Verteilung schief ist oder Ausreißer enthält. Wenn ja, sollten Sie über robustere Maße nachdenken – etwa den Interquartilsabstand (IQR) oder die mittlere absolute Abweichung (MAD). Diese Maße reagieren weniger empfindlich auf extreme Werte und geben ein realistischeres Bild der Streuung.
Und wenn Sie trotzdem die Standardabweichung verwenden wollen? Dann interpretieren Sie sie mit Vorsicht. Sie sagt Ihnen immer noch, wie stark die Daten im Schnitt streuen – aber sie gibt keine Auskunft über die Form der Verteilung.
Warum teilt man bei der Stichprobenvarianz durch n-1 und nicht durch n?
Das ist die berühmte Bessel-Korrektur. Der Grund: Wenn Sie die Varianz einer Stichprobe berechnen, neigt diese dazu, die Populationsvarianz zu unterschätzen. Warum? Weil Sie den Mittelwert der Stichprobe verwenden – und der liegt oft näher an den Stichprobenwerten als der wahre Populationsmittelwert. Die Bessel-Korrektur gleicht diesen Bias aus.
Mathematisch ausgedrückt: Die Summe der quadrierten Abweichungen vom Stichprobenmittelwert ist immer kleiner als die Summe der quadrierten Abweichungen vom Populationsmittelwert. Durch Division durch n-1 statt n erhalten Sie einen erwartungstreuen Schätzer für die Populationsvarianz. Das ist entscheidend für statistische Tests und Konfidenzintervalle.
Doch Vorsicht: Die Bessel-Korrektur ist kein Allheilmittel. Bei kleinen Stichproben kann sie zu einer Überschätzung der Varianz führen. Und wenn Sie die gesamte Population vor sich haben, sollten Sie trotzdem durch n teilen – nicht durch n-1.
Verdict: Warum Varianz und Standardabweichung mehr sind als nur Zahlen
Varianz und Standardabweichung sind keine trockenen Statistik-Konzepte. Sie sind Werkzeuge – und wie bei jedem Werkzeug kommt es darauf an, wie Sie es einsetzen. Sie können Ihnen verraten, ob Ihre Produktion stabil läuft, ob Ihr Portfolio zu riskant ist oder ob Ihr Experiment tatsächlich etwas Neues entdeckt hat. Doch sie können Ihnen auch falsche Sicherheit vorgaukeln, wenn Sie sie falsch interpretieren.
Die Varianz ist das mathematische Rückgrat der Statistik. Sie ermöglicht fortgeschrittene Analysen und ist unverzichtbar für Modelle wie die Regression oder die Varianzanalyse. Doch sie ist unhandlich – eine Zahl in Quadrat-Einheiten, die niemand intuitiv versteht. Die Standardabweichung ist die praktische Übersetzung. Sie bringt die Streuung zurück in die ursprüngliche Einheit und macht sie greifbar. Doch auch sie hat ihre Grenzen. Sie reagiert empfindlich auf Ausreißer und sagt nichts über die Form der Verteilung aus.
Was ist die wichtigste Lektion? Zahlen allein sagen nichts aus. Varianz und Standardabweichung sind nur so gut wie der Kontext, in dem Sie sie verwenden. Sie müssen verstehen, was Ihre Daten wirklich aussagen – und welche Fragen Sie damit beantworten wollen. Und Sie müssen bereit sein, über den Tellerrand zu schauen. Wenn Ihre Daten nicht normalverteilt sind, wenn sie Ausreißer enthalten oder wenn die Stichprobe zu klein ist, brauchen Sie andere Werkzeuge.
Am Ende geht es nicht um Formeln, sondern um Erkenntnis. Varianz und Standardabweichung sind Mittel zum Zweck – nicht das Ziel. Sie helfen Ihnen, die Welt ein bisschen besser zu verstehen. Aber sie ersetzen nicht das Denken. Also: Nutzen Sie sie klug. Und hinterfragen Sie sie immer wieder.
Denn Statistik ist wie Kochen. Die besten Zutaten nützen nichts, wenn Sie nicht wissen, was Sie damit anfangen sollen.